
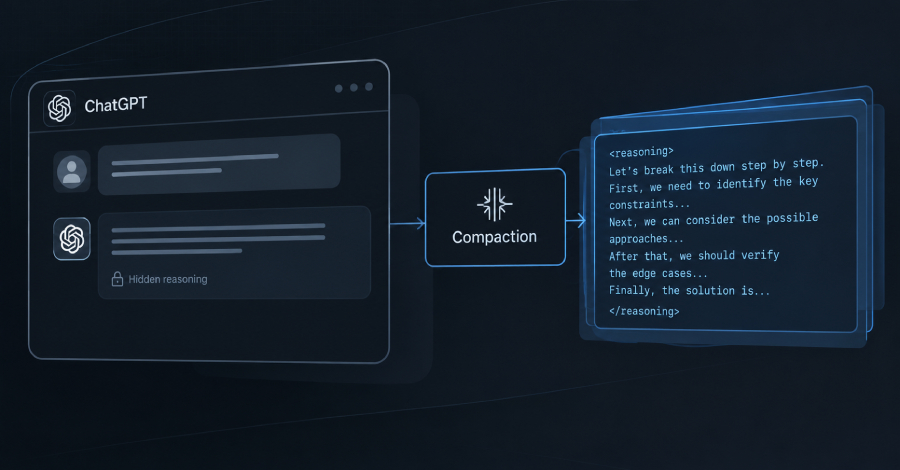
La funzione di compaction, il meccanismo con cui OpenAI comprime le conversazioni più lunghe per ridurre il consumo di contesto, può essere trasformata in una via per estrarre in chiaro il ragionamento nascosto dei modelli. È quanto hanno documentato alcuni ricercatori, i quali hanno mostrato come aggirare le protezioni pensate per impedire che il cosiddetto chain of thought venga letto direttamente dagli utenti.
La scoperta tocca un tema centrale nell’attuale dibattito sull’intelligenza artificiale: quello dell’interpretabilità e della sicurezza dei modelli, vale a dire la possibilità di capire e, soprattutto, di proteggere il percorso di ragionamento che porta a una risposta.
Che cos’è la compaction e dove sta il problema
Quando una conversazione diventa molto lunga, il modello ha bisogno di riassumerne o comprimerne i contenuti per continuare a lavorare senza esaurire la memoria disponibile. In questo processo di sintesi il sistema rielabora anche parti del proprio ragionamento interno, ed è proprio in questo passaggio che i ricercatori hanno individuato un punto debole.
Attraverso richieste costruite ad arte, sarebbe possibile spingere il modello a restituire, in forma leggibile, frammenti del ragionamento che normalmente vengono tenuti nascosti. Le protezioni presenti non risultano sempre efficaci nel distinguere tra ciò che può essere mostrato e ciò che dovrebbe restare interno.
Perché il ragionamento nascosto conta
Molti modelli di ultima generazione separano deliberatamente il ragionamento dalla risposta finale: il primo resta interno, la seconda viene mostrata all’utente. Questa separazione serve sia a migliorare la qualità delle risposte sia a rendere più difficile estrarre le dinamiche interne del sistema, che potrebbero rivelare informazioni sensibili o tecniche utilizzabili per aggirare i controlli.
Se il confine tra ragionamento e risposta si indebolisce, cresce il rischio che un utente malintenzionato ricavi indicazioni utili a costruire attacchi o a far emergere contenuti che il modello dovrebbe filtrare. La scoperta è quindi rilevante per chiunque utilizzi modelli in contesti dove la riservatezza e la robustezza sono requisiti.
Implicazioni per chi usa modelli OpenAI
Per le aziende che integrano questi modelli nelle proprie applicazioni, l’episodio è un promemoria a non affidarsi soltanto alle protezioni dichiarate dal fornitore. Le applicazioni che espongono un modello a prompt generati dagli utenti dovrebbero prevedere ulteriori livelli di controllo, come filtri sulle risposte, limitazioni dei casi d’uso e una supervisione periodica dei comportamenti osservati.
La sicurezza dei modelli non è una proprietà statica: i sistemi evolvono e con essi compaiono nuove tecniche per sondarne i limiti. Mantenere aggiornati i componenti e verificare con test mirati la robustezza di ciò che si mette in produzione resta la contromisura più concreta.
Il caso della compaction conferma che l’interpretabilità non è soltanto una questione accademica: da essa dipendono, in ultima analisi, la fiducia e la sicurezza con cui le aziende possono adottare i modelli più avanzati.
Fonte: The Hacker News — https://thehackernews.com/2026/10/openai-compaction-flaw-let-researchers.html